Laboratório
ResearchOps
Beta em produçãoAnonimização de dados pessoais em prints e gravações de tela para pesquisa de UX: a detecção roda no navegador, a tarja é gravada nos pixels e a trilha de auditoria guarda quem fez o quê, nunca o dado.
1 de 5
Contexto
Em pesquisa de UX, benchmark de apps é trabalho de acervo. Prints e gravações de tela de apps de terceiros são juntados ao longo de semanas, em rodadas, e viram slides de comparação, com uma seção por funcionalidade e um slide por app.
Quando os apps são de banco, cada print pode trazer nome, CPF, conta, chave Pix ou e-mail de quem aparece na tela. Antes de circular, isso precisa ser coberto de um jeito que não se desfaz, e alguém precisa poder mostrar depois quem cobriu o quê. A LGPD é o motivo; o acervo e o deck são o trabalho.
O problema
As ferramentas à mão não foram feitas para isso. A tarja feita num editor de imagem pode ficar numa camada que se remove, o desfoque pode ser revertido, e nenhum dos dois registra quem tarjou o quê. Um serviço de IA na nuvem acha o dado sozinho, mas recebe a imagem original, justamente com o dado que se queria proteger.
Parte dos apps bloqueia captura de tela, e o material bruto vira gravação ou vídeo filmado do celular, com os quadros escolhidos um a um. E o deck é remontado à mão a cada rodada.
O que construímos
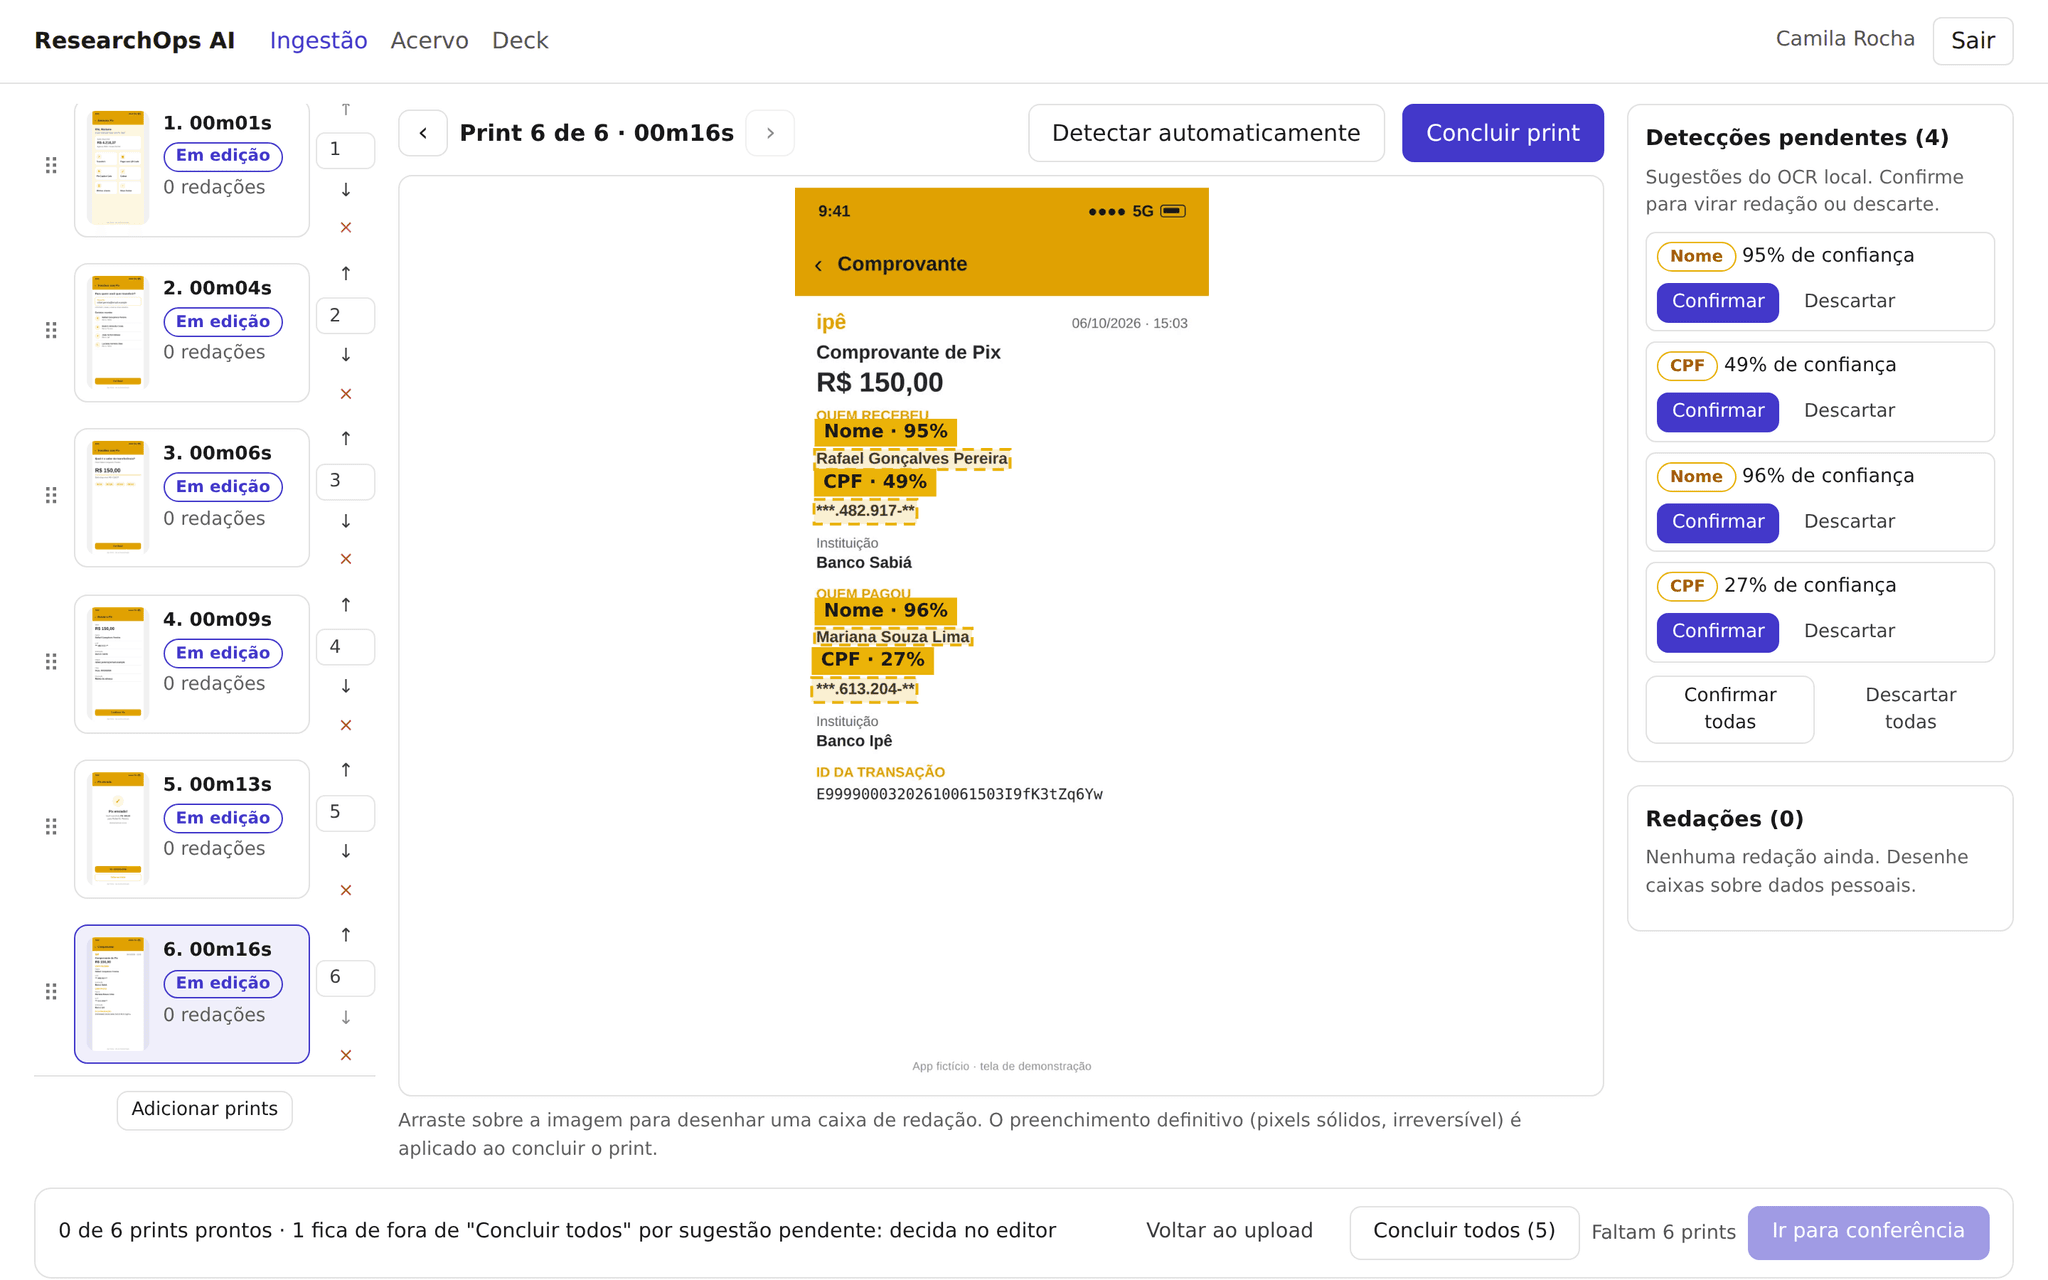
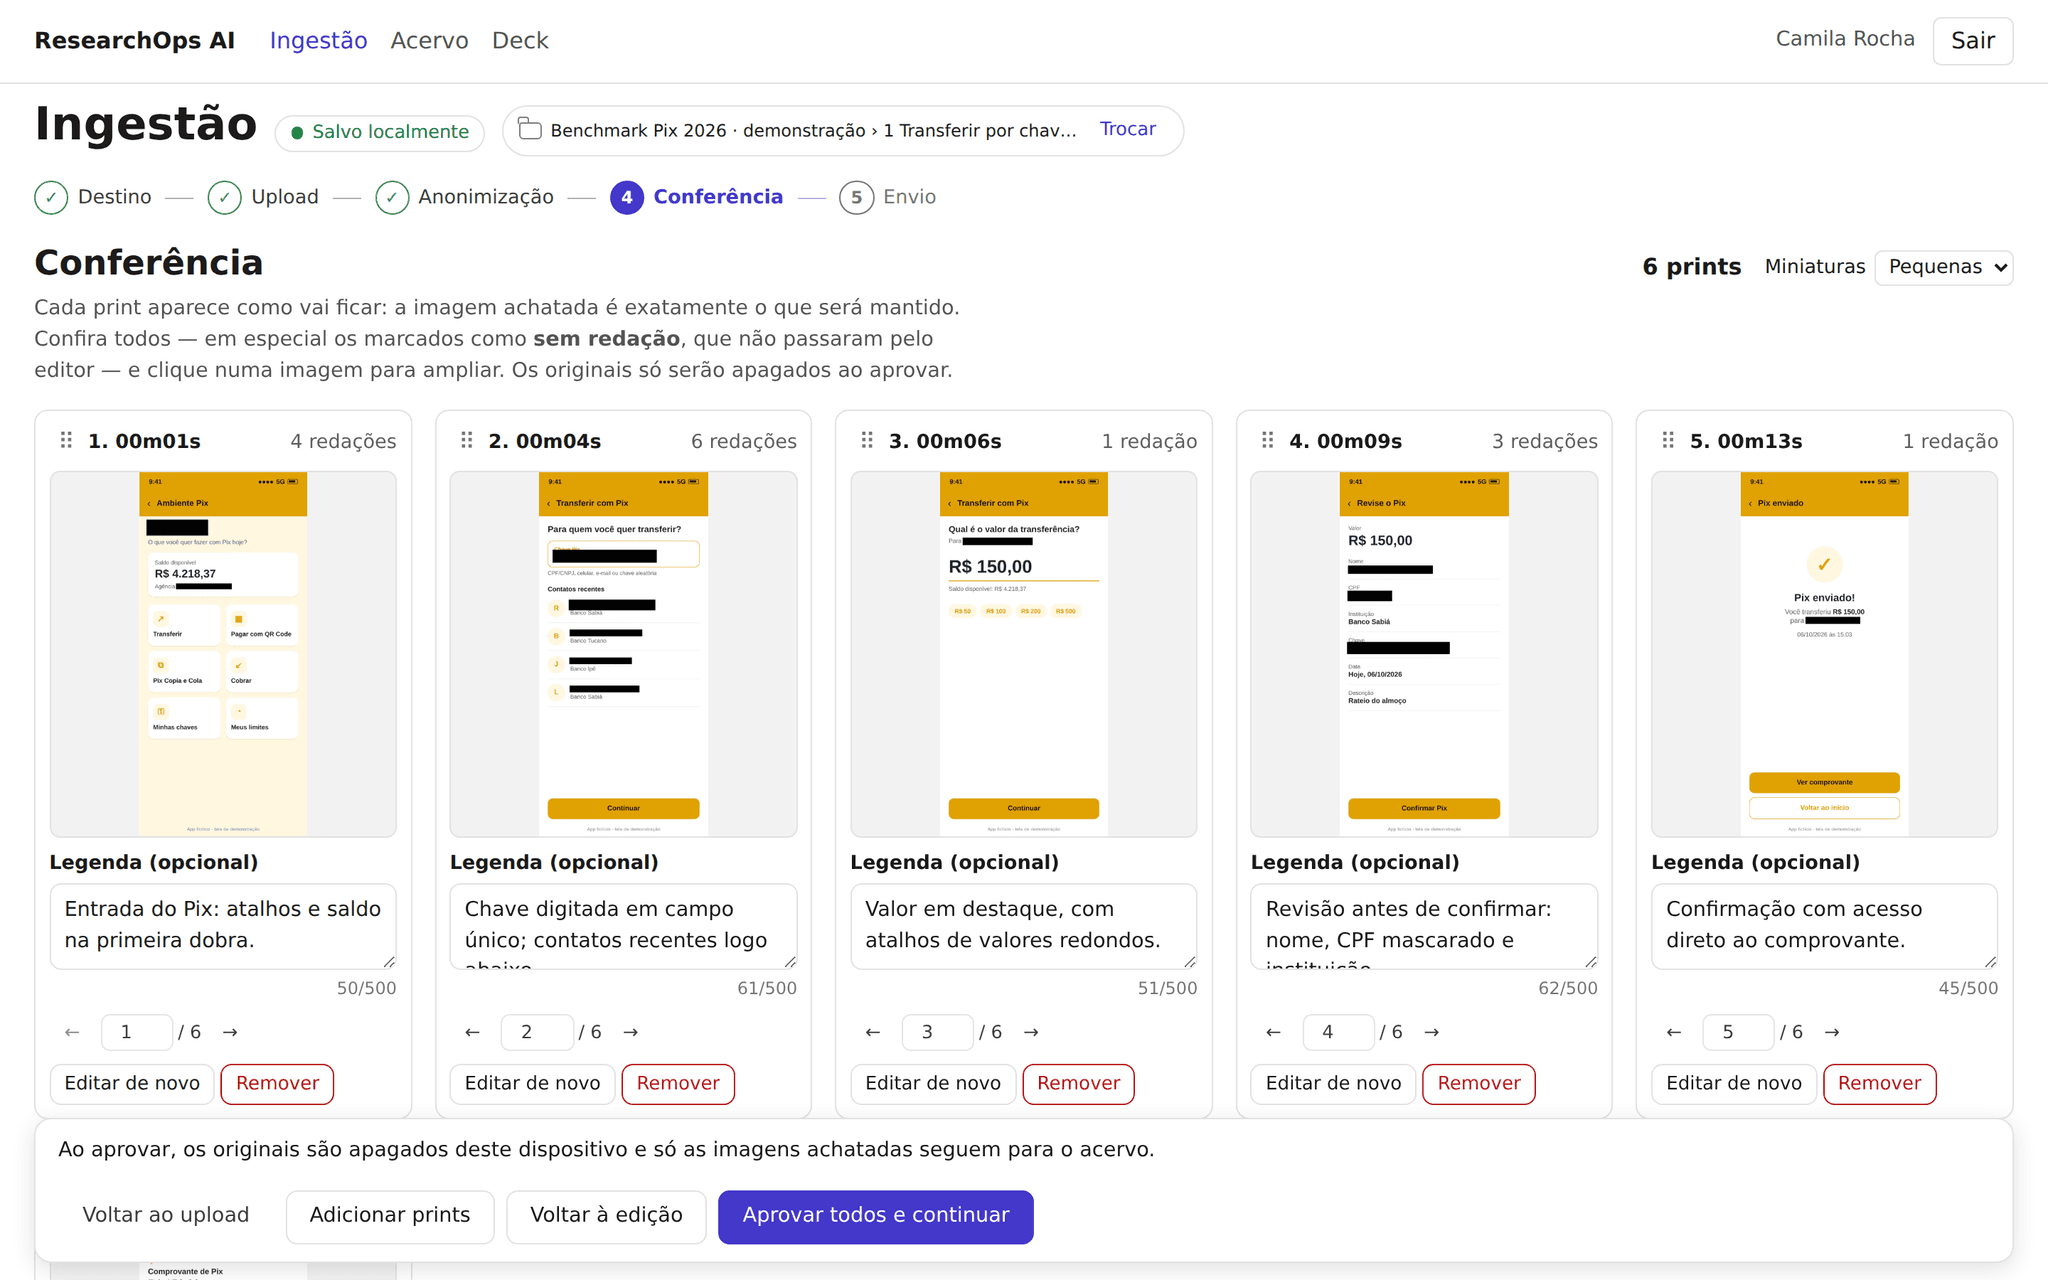
O ResearchOps é um produto próprio que cobre o caminho inteiro, do print ao deck. A pesquisadora escolhe o projeto e a pasta e solta os prints ou a gravação de tela; do vídeo, o sistema extrai um quadro por estado de tela. Em cada print, a detecção sugere caixas sobre documentos brasileiros (CPF, CNPJ, CNH, chave Pix, boleto, placa, agência e conta), sobre valores ao lado de rótulos como "Favorecido" e sobre nomes de pessoa. Ela confirma, cobre à mão o que faltou e confere cada print na versão final antes de enviar.
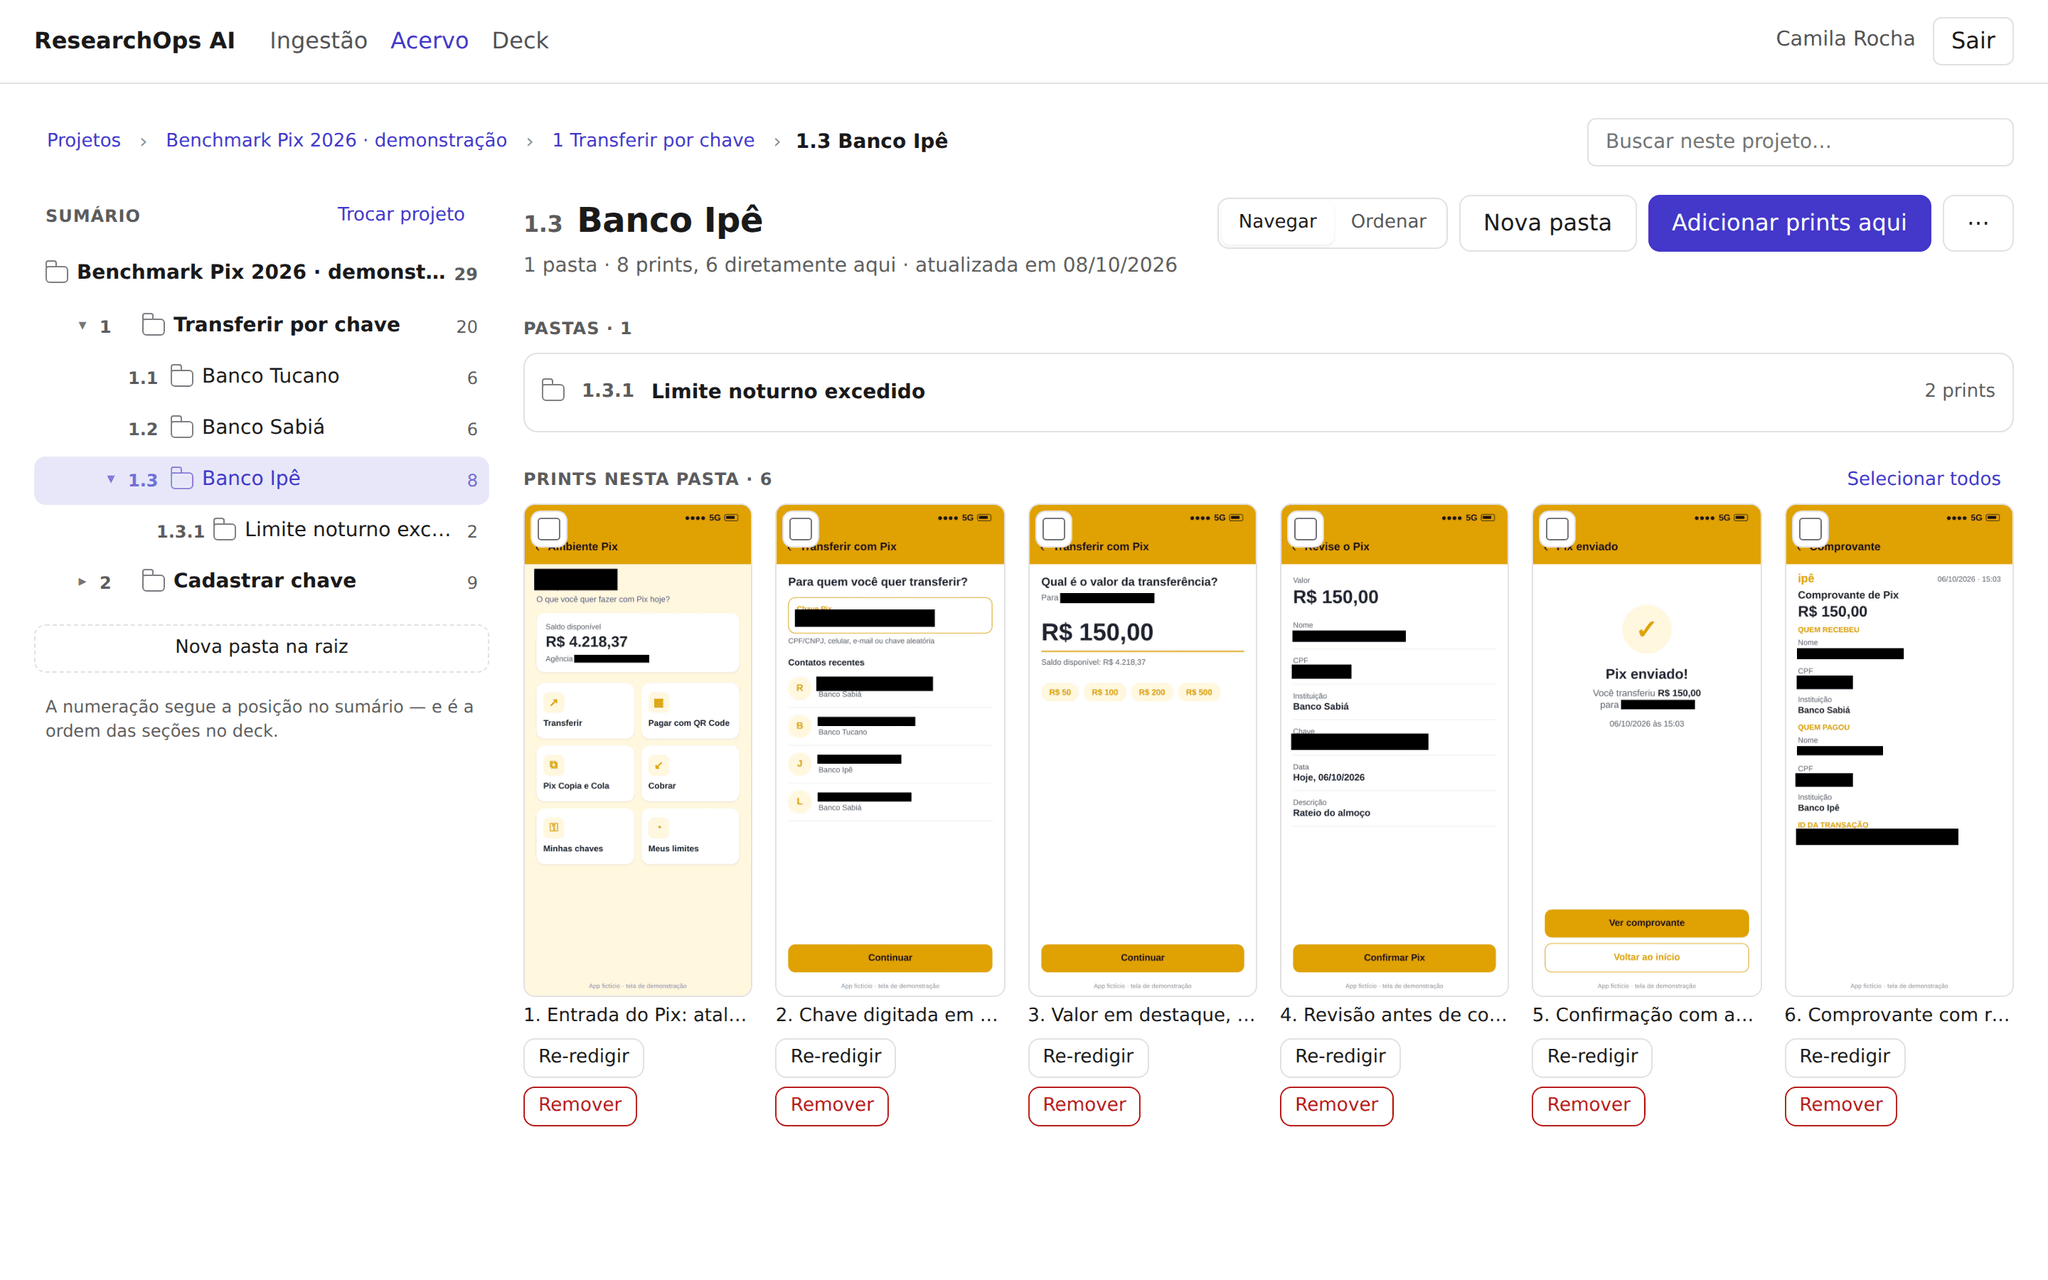
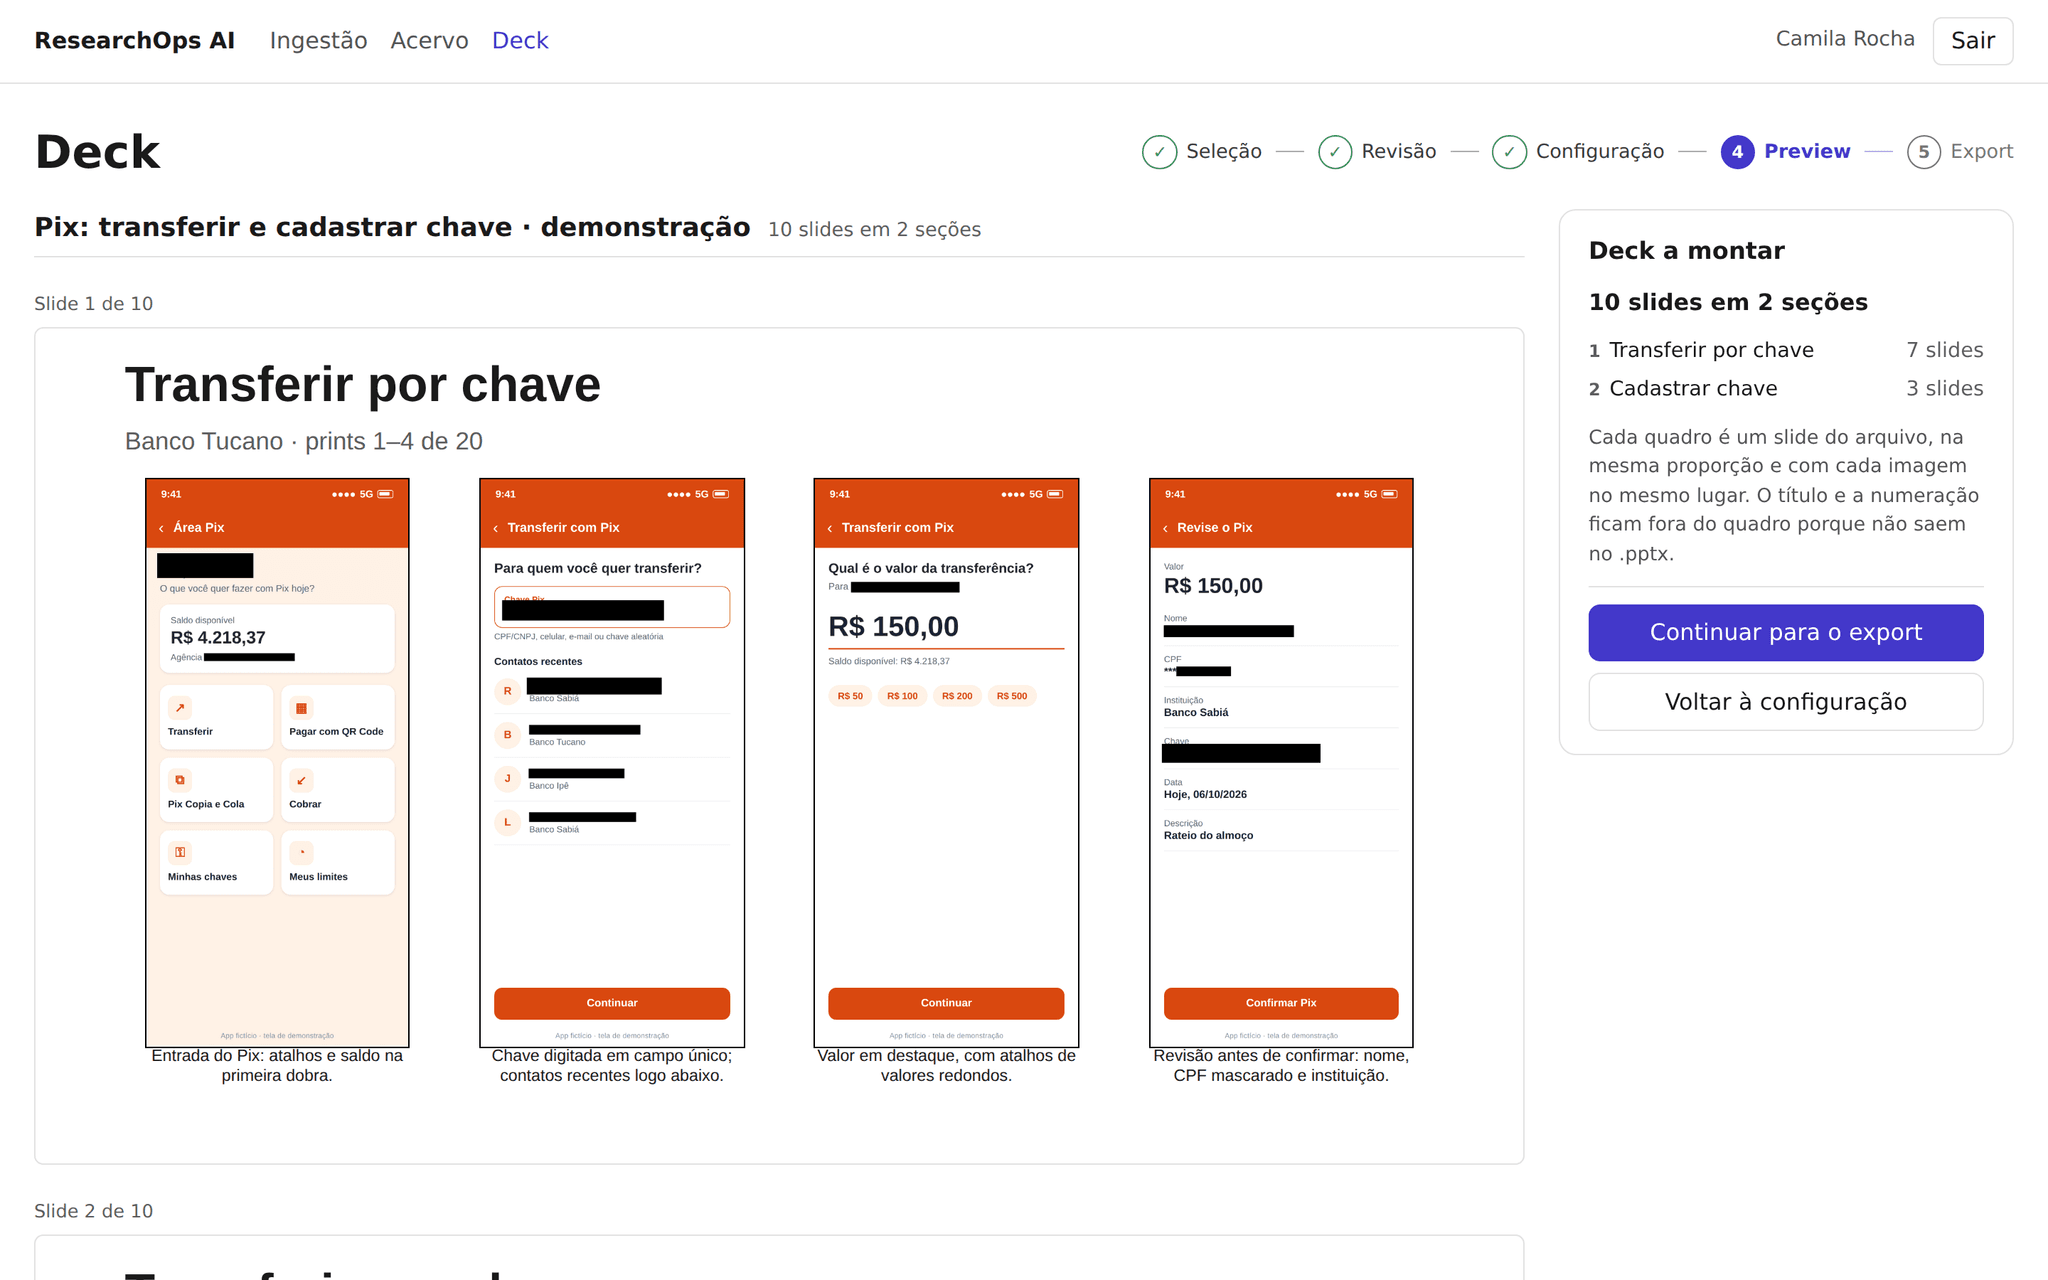
No acervo, os prints ficam em projeto, pastas e subpastas numeradas, alimentados em várias rodadas e por mais de uma pessoa. Marcando pastas, sai um deck PowerPoint: cada pasta de primeiro nível vira uma seção, com até quatro prints por slide. Três papéis, Pesquisador, Visualizador e Admin, dividem o que cada pessoa pode fazer.
Decisões técnicas
A imagem com dado pessoal não sai do computador
Leitura do texto, detecção, tarja e extração de quadros do vídeo rodam no navegador. O servidor só recebe a imagem já achatada, depois da Conferência, e nesse momento os originais são apagados do navegador. A detecção é por regras (dígito verificador, rótulos, lista de nomes), sem serviço de IA externo: nenhum dado vai a terceiro.
Tarja gravada nos pixels, nunca em camada
A tarja é um preenchimento sólido gravado numa imagem nova, sem camada, desfoque ou pixelização: o dado coberto deixa de existir no arquivo. Sugestão da detecção nunca vira tarja sozinha, e print com sugestão pendente fica de fora do "concluir todos" até alguém decidir.
Uma trilha de auditoria que nem o banco altera
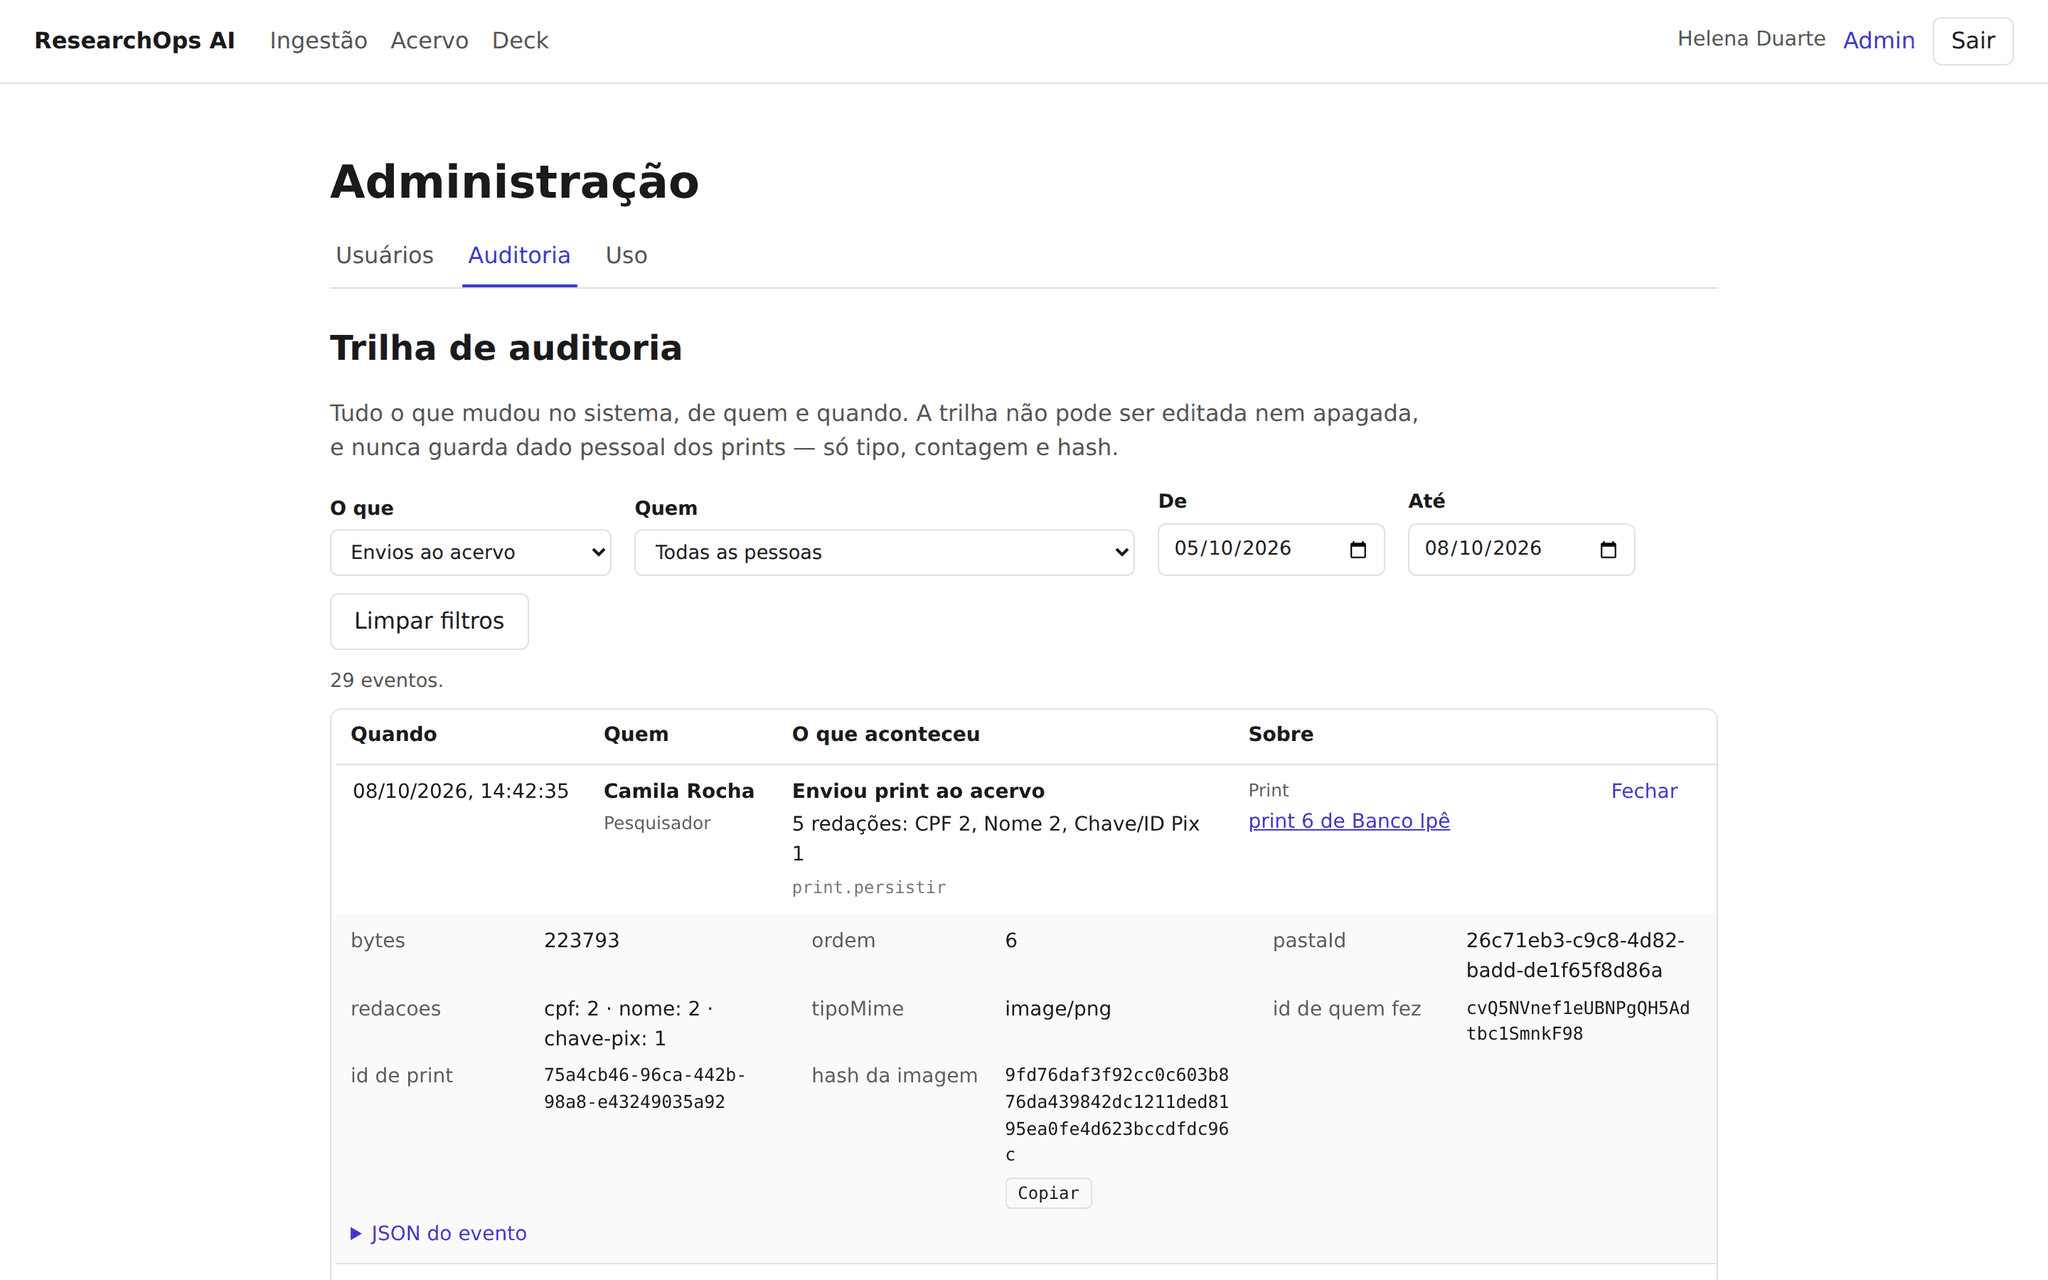
Envio, reorganização, nova redação, remoção e exportação entram numa trilha com autor, horário, tipo e contagem das redações e o hash da imagem, nunca o conteúdo coberto. Um gatilho no PostgreSQL recusa alteração e exclusão, e o evento é gravado na mesma transação da mudança. O deck só é entregue depois de a trilha aceitar o registro da exportação.
O que sai é o que passou pela Conferência
O hash SHA-256 de cada imagem é calculado no navegador, recalculado no servidor e conferido de novo antes de cada .pptx e .zip. Se uma imagem mudou depois da revisão, a exportação para e diz qual slide.
Resultado e estado atual
O ResearchOps está no ar desde setembro de 2026, em beta fechado, com acesso por convite: não há cadastro aberto, e as contas são criadas por uma pessoa Admin. No computador, o fluxo funciona de ponta a ponta, do vídeo ou dos prints ao deck e à trilha; no celular, acervo, deck e trilha já funcionam. Mais de 600 testes unitários rodam no CI a cada pull request.
Ficam registrados em aberto: a precisão da detecção ainda não foi medida em material real, e a retenção dos dados e o atendimento ao titular têm posição escrita, pendente de validação jurídica. As telas desta página usam dados de demonstração, com bancos, pessoas e comprovantes fictícios; o cabeçalho delas ainda traz o nome antigo do produto, ResearchOps AI.
Stack
- TypeScript
- TanStack Start
- PostgreSQL
- Prisma
- Tesseract.js
- PptxGenJS
Seu trabalho passa por dado pessoal?
Se a pesquisa depende de limpar, tarjar e organizar dados à mão a cada rodada, e ninguém consegue mostrar depois quem fez o quê, vale uma conversa de 30 minutos.